4 × Tesla V100 32GB + E5 雙路 8 卡機
低價生成速度5.1t/s
記憶體頻寬137GB/s
- 電源
- 內建 4 × 1,600 W 電源
- 含在準系統內
整機參考價NT$221,365
 Kimi K3.1 Pro 如何本地部署?
Kimi K3.1 Pro 是月之暗面的 2.8T 參數 MoE,10 月 24 日在 API 上線,11 月 4 日開源權重。4-bit 約需 1,509 GB 顯示記憶體,單卡和單台工作站都放不下。它是 Kimi K3 加強後訓練的版本,能看圖,上下文 1M;架構只改了一處,24 層全注意力換成了稀疏注意力 DSA。官方原版權重約 1,561 GB,用 vLLM 跑要 8 張 288GB 顯示記憶體的資料中心卡。GGUF 還沒出來,1-bit 到 4-bit 的顯示記憶體暫時依 K3 的檔案估算。
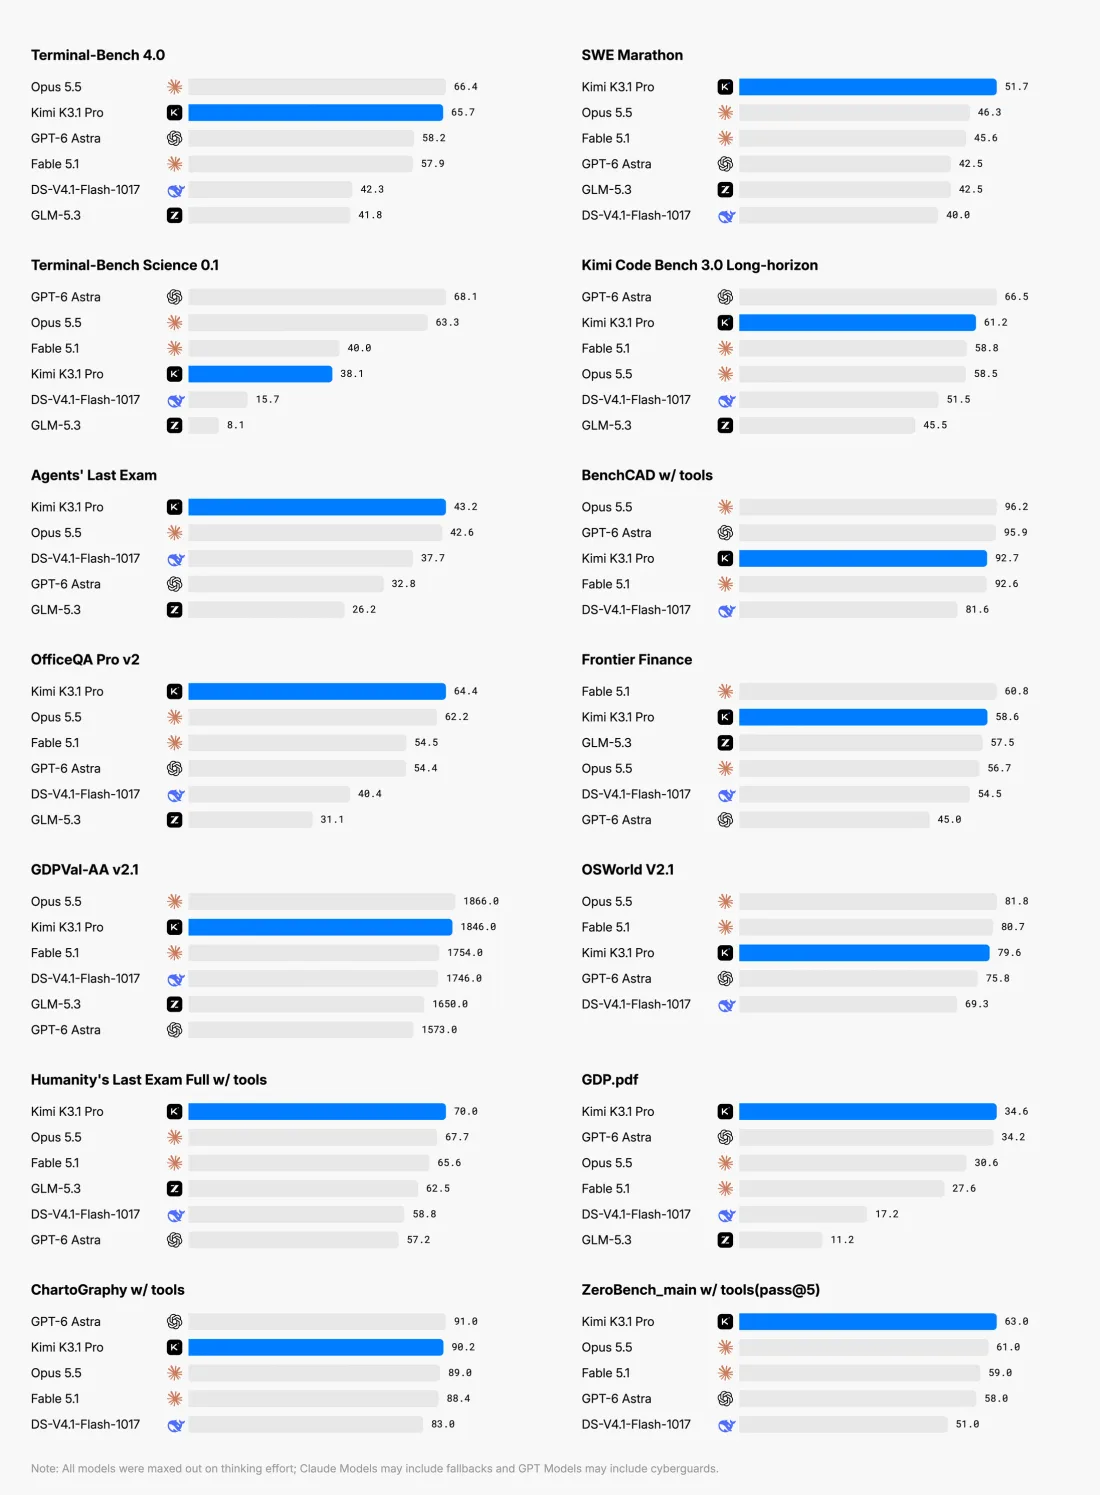
Kimi K3.1 Pro 比 K3 強在寫程式、做 3D 和金融分析,部署門檻基本不變:參數量和原版體積都和 K3 一樣,只把 24 層全注意力換成了稀疏注意力 DSA,放得下 K3 的硬體就放得下它。官方跑分中,在終端機裡完成程式設計任務的 Terminal-Bench 4.0 拿到 65.7,和 Claude Opus 5.5 的 66.4 只差不到 1 分;內部的長程程式設計測試從 K3 的 56.0 提高到 61.2。幻覺也少了很多:在官方刻意出難題的事實查核測試裡,單一陳述出錯的比例從 K3 的 23.4% 降到 8.3%。這些分數都是月之暗面自己公布的,測試方法見圖下方的原文。
Kimi K3.1 Pro 在本機部署和 K3 一樣,最少也要幾百 GB 顯示記憶體:1-bit 約 649 GB,2-bit 約 861 GB,4-bit 約 1,509 GB。8-bit 約 1,561 GB,只比 4-bit 大一點,因為專家在訓練時就是 4-bit,官方釋出的原版權重也是這麼大。上下文很省顯示記憶體:93 層中只有 24 層的快取會隨上下文變長,4-bit 從 32K 開到 1M 只多約 28 GB。K3.1 Pro 的 GGUF 還沒出來,各檔暫時依 K3 對應檔位的檔案估算,兩者的參數量和原版體積幾乎一樣,出來後會換成實測值。
| 量化 | 權重體積GB | 32K 上下文GB | 128K 上下文GB | 256K 上下文GB | 1M 上下文(最大)GB |
|---|---|---|---|---|---|
| 1-bit | 648.9估 | 650.9 | 653.6 | 657.2 | 679 |
| 2-bit | 861.3估 | 863.3 | 866 | 869.6 | 891.4 |
| 3-bit | 1,440.6估 | 1,442.6 | 1,445.3 | 1,448.9 | 1,470.7 |
| 4-bit | 1,508.7估 | 1,510.7 | 1,513.4 | 1,517 | 1,538.8 |
| 5-bit | — | — | — | — | — |
| 8-bit | 1,561.2估 | 1,563.2 | 1,565.9 | 1,569.5 | 1,591.3 |
| BF16/FP16 | 5,880估 | 5,882 | 5,884.7 | 5,888.3 | 5,910.1 |
詳細計算規則可在資料方法頁查看。
不能,單卡、單台工作站都放不下,和 K3 一樣。最小的 1-bit 約 649 GB,已經超過 512GB 的 Mac Studio M3 Ultra;2-bit 約 861 GB,8 張 96GB 卡加起來也放不下。放得下的是幾台 512GB 的 Mac Studio 串接:2-bit 要兩台,4-bit 要四台。
| 裝置 | 需要幾張 | 總價 | 總顯示記憶體 | 速度 t/s | 總功耗 |
|---|---|---|---|---|---|
| Mac Studio M3 Ultra 512GB單台 512 GB | 2 台 | NT$1,289,985 | 1,024 GB | 17.7 | 960 W |
| 裝置 | 需要幾張 | 總價 | 總顯示記憶體 | 速度 t/s | 總功耗 |
|---|---|---|---|---|---|
| Mac Studio M3 Ultra 512GB單台 512 GB | 4 台 | NT$2,579,969 | 2,048 GB | 10.6 | 1,920 W |
| 裝置 | 需要幾張 | 總價 | 總顯示記憶體 | 速度 t/s | 總功耗 |
|---|---|---|---|---|---|
| Mac Studio M3 Ultra 512GB單台 512 GB | 4 台 | NT$2,579,969 | 2,048 GB | 10.2 | 1,920 W |
Mac Studio 以 Thunderbolt 5 線串接,要用 MLX 或 exo 執行,vLLM 不支援。詳細計算規則可在資料方法頁查看。
把專家放在記憶體裡跑 Kimi K3.1 Pro,要伺服器級的整機:雙路 EPYC(24 通道 DDR5)插滿 1.5TB 記憶體,配 4 張 RTX 5090 放一部分專家,4-bit 約 14 tokens/s。降到 2-bit,記憶體減半到 768GB,速度反而升到約 23 tokens/s。舊硬體也湊得出來:2-bit 下 4 張 V100 32GB 加 768GB DDR4 的老伺服器也能跑,但只有約 6 tokens/s。這種跑法要靠 llama.cpp 這類工具,得等 K3.1 Pro 的 GGUF 出來;在那之前,同樣的機器可以先跑 Kimi K3。
部分購買連結是聯盟連結:透過它們購買時我們可能獲得佣金,你支付的價格不變。
官方釋出的是原版 MXFP4 權重:專家是 4-bit,注意力、共享專家和視覺部分是 BF16,總共約 1,561 GB,和 K3 一樣大。vLLM 官方配方用 8 張卡做張量平行,可以是一台 8 卡 B300、兩個 GB300 托盤或一台 8 卡 MI355X 伺服器,顯示記憶體合計至少約 1,874 GB,要用 nightly 版或專用映像檔 vllm/vllm-openai:kimi-k31。SGLang 和 TokenSpeed 也有官方部署教學。
和 K3 一樣,思考始終開啟,只能用 reasoning_effort 選擇 low、high、max,預設 max。官方跑分用的是 temperature 1.0、top_p 0.95,自行部署時照這個設定。多輪對話和工具呼叫時,要把回傳的整則回覆原樣送回去,包括 reasoning_content 和 tool_calls。
截至 11 月 4 日,還沒有 K3.1 Pro 的 GGUF。llama.cpp 主線已經支援 K3 的文字部分(PR #26185),但 K3.1 Pro 把 24 層全注意力從 MLA 換成了 DSA,現有的支援能不能直接載入,要等 GGUF 出來實測。想把專家放在記憶體、在自己的伺服器上跑,眼下只能先用 Kimi K3。
授權條款叫 Kimi K3.1-Pro License,內容和 K3 的逐字相同,只換了名稱。經營「模型即服務」、讓第三方能控制輸入和參數的公司,連續 12 個月營收超過 2,000 萬美元,商用前要和月之暗面另行簽約;產品月活躍用戶超過 1 億或月營收超過 2,000 萬美元,要在介面上明顯標示「Kimi K3.1-Pro」。只在公司內部使用,或透過月之暗面官方及認證服務商呼叫,這兩條都不適用。
 vLLM
vllm serve moonshotai/Kimi-K3.1-Pro \
  --trust-remote-code \
  --tensor-parallel-size 8 \
  --load-format fastsafetensors \
  --enable-auto-tool-choice \
  --tool-call-parser kimi_k3 \
  --reasoning-parser kimi_k3
Ollama 庫暫無官方標籤。
量化檔名以模型庫當週抓取為準,口徑見資料方法。 資料方法
| 模型 | 總參數 | 激活參數 | 4-bit 模型大小 |
|---|---|---|---|
| Kimi Linear 48B A3BMoE | 49.1B | 3B | 30.1 GB |
| Kimi K2MoE | 1,000B | 32B | 621.3 GB |
| Kimi K2.5MoE | 1,000B | 32B | 621.2 GB |
| Kimi K2.6MoE | 1,000B | 32B | 583.7 GB |
| Kimi K2.7 CodeMoE | 1,000B | 32B | 583.7 GB |
| Kimi K3MoE | 2,800B | 104B | 1,508.7 GB |