Tesla V100 32GB + E5 双路 DDR4
低价出字速度22t/s
内存带宽137GB/s
整机参考价¥13,261
 DeepSeek V4.1 Flash 如何本地部署?
DeepSeek V4.1 Flash 是 2026 年 9 月发布的多模态 MoE,按权重文件算有 763B 参数,任何单卡和 128GB 整机都装不下。10 月 17 日放出的 1017 版只换了权重,部署门槛不变。它的参数里有一大块是查表用的「Engram 记忆」,这部分可以放进主机内存,只有约 300 GB 必须进显存。官方原版权重要用 vLLM 跑;社区 GGUF 主线 llama.cpp 还不能加载,但 ik_llama.cpp 已经支持,可以把专家放进内存跑;Ollama 只有云端版。
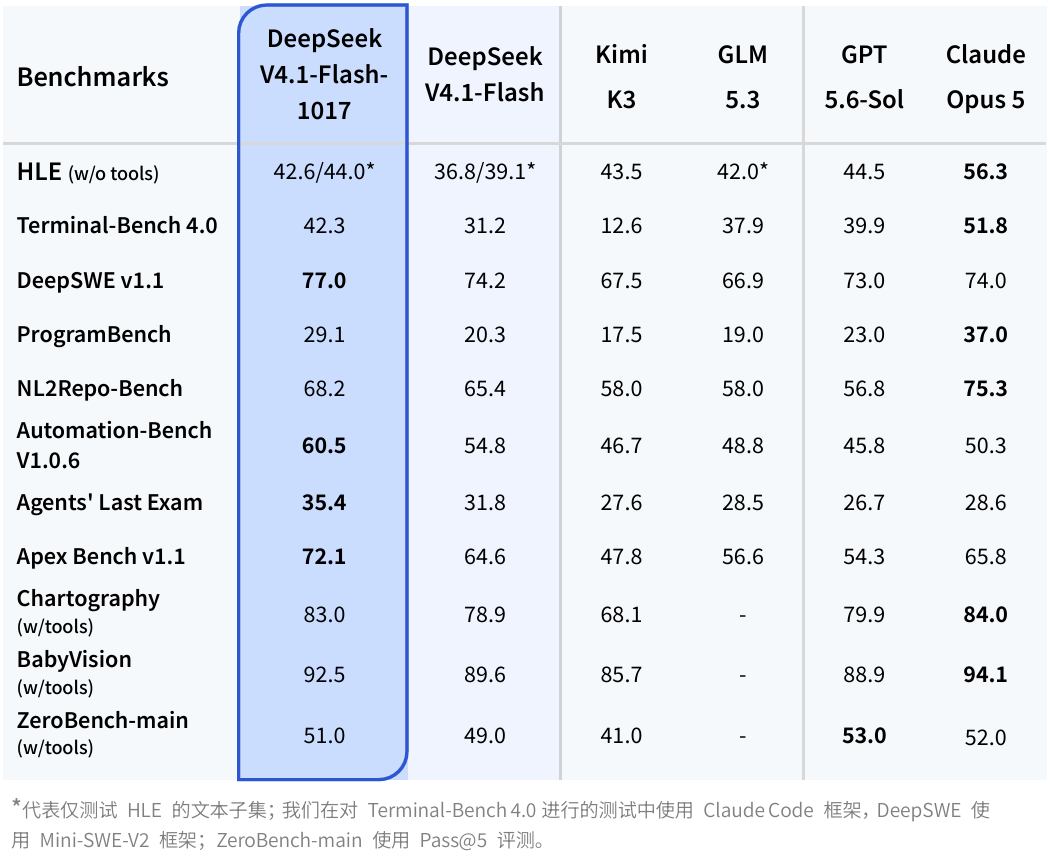
1017 是 DeepSeek 在 10 月 17 日放出的新版权重:推理、写代码、agent 任务和看图的跑分都有提升,回答也更短,模型结构和文件体积则和 9 月首发版完全一样。官方跑分里涨得最多的是在终端里完成任务的 Terminal-Bench 4.0,从 31.2 升到 42.3;同样的任务用的 token 更少,完成得也更快。显存需求和能跑的硬件都没变,已经在跑 9 月版的,把启动命令里的模型名换成 DeepSeek-V4.1-Flash-1017 就行;NVIDIA 的 NVFP4 版还没跟进,用它跑到的仍是 9 月权重。
全放进显存最少也要约 266 GB,消费卡、工作站卡和常见的 128GB 整机都不够。按社区 GGUF 算,2-bit 约 266 GB,4-bit 约 446 GB;它的上下文非常省显存,从 32K 开到 1M 只多不到 1 GB。这些 GGUF 主线 llama.cpp 还加载不了,要用 ik_llama.cpp,它能把专家和 Engram 表放进内存,4-bit 下显卡只放约 5 GB。用 vLLM 跑官方权重时,约 300 GB 必须放进显存,另外约 203 GB 的 Engram 查找表可以放进主机内存。
模型大小按官方 Hugging Face 仓库的 Model size 显示为 763B;模型卡中的 552B 指骨干参数,另列约 196B Engram。下列文件大小包含 GGUF 内的 Engram 查表,按实际分片求和,不由参数量乘以量化位宽推算。仅核验了文件大小,未验证量化质量或实际运行占用。
| 量化 | 权重体积GB | 32K 上下文GB | 128K 上下文GB | 256K 上下文GB | 1M 上下文(最大)GB |
|---|---|---|---|---|---|
| 1-bit | — | — | — | — | — |
| 2-bit | 264.5GGUF | 265.6 | 265.7 | 265.8 | 266.5 |
| 3-bit | 347.3GGUF | 348.4 | 348.5 | 348.6 | 349.3 |
| 4-bit | 444.7GGUF | 445.8 | 445.9 | 446 | 446.7 |
| 5-bit | — | — | — | — | — |
| 8-bit | 508GGUF | 509.1 | 509.1 | 509.3 | 510 |
| BF16/FP16 | — | — | — | — | — |
详细计算规则可在数据方法页查看。
不能,差得很远:单张显卡最多 96GB,它压到 2-bit 也要约 266 GB。它有一大块参数是查表用的记忆数据,每出一个字只查其中几行,可以挪进主机内存;可挪走之后,必须留在显存里的部分仍有约 300 GB。整机里容量够的只有 512GB 的 Mac Studio M3 Ultra,但社区做的量化文件,主线 llama.cpp 和 Ollama 现在都还加载不了,Mac 上只能试 DwarfStar 的专用分支,它配套的权重还停在 9 月版,算不上稳妥。想正经跑有两条路:几张 96GB 的卡加 vLLM,或者用 ik_llama.cpp 把专家和 Engram 表放进内存,4-bit 下一张 24GB 的卡加 512 GB 内存的服务器就能跑。
| 设备 | 价格 | 速度 t/s | 最大上下文 |
|---|---|---|---|
| Mac Studio M3 Ultra 512GB整机 · 512 GB | ¥125,1003 条挂单 | — | 1M |
| 设备 | 价格 | 速度 t/s | 最大上下文 |
|---|---|---|---|
| Mac Studio M3 Ultra 512GB整机 · 512 GB | ¥125,1003 条挂单 | — | 1M |
| 设备 | 价格 | 速度 t/s | 最大上下文 |
|---|---|---|---|
| Mac Studio M3 Ultra 512GB整机 · 512 GB | ¥125,1003 条挂单 | — | 1M |
只列常见的显卡和整机,按价格从低到高排。
最小的组合是 4 张 96GB 的 RTX PRO 6000,前提是用 vLLM 跑官方权重,并把查表用的那块记忆数据放进主机内存:显卡只放必须进显存的部分,主机要空出约 203 GB 内存。这样跑 4-bit,每秒约 68 个 token。48GB 的卡凑满 8 张,总显存一样却装不下,因为有一部分权重要在每张卡上各放一份,卡越小越吃亏。官方配方只验证过 8 张 H100、H200 这类数据中心硬件,四卡方案是按容量和带宽推算的,动手前先确认 vLLM 对这张卡的支持。
| 设备 | 需要几张 | 总价 | 总显存 | 速度 t/s | 总功耗 |
|---|---|---|---|---|---|
| Instinct MI210单卡 64 GB | 8 张Engram 放内存 | ¥147,992 | 512 GB | 64 | 2,400 W |
 RTX PRO 5000 72GB单卡 72 GB | 8 张Engram 放内存 | ¥475,112 | 576 GB | 55.5 | 2,400 W |
| RTX PRO 6000单卡 96 GB | 4 张Engram 放内存 | ¥519,996 | 384 GB | 68.1 | 2,400 W |
| A100 80GB PCIe单卡 80 GB | 8 张Engram 放内存 | ¥1,120,000 | 640 GB | 71.7 | 2,400 W |
标「Engram 放内存」的另需约 203 GB 系统内存。详细计算规则可在数据方法页查看。
适合手头有大内存服务器、又凑不齐几张 96GB 卡的人:用 ik_llama.cpp 把专家和两张 Engram 表都放进内存,显卡主要放注意力这类常驻部分,只配一张卡时,4-bit 要 512 GB 左右的内存。显卡越多,能留在卡上的专家越多、需要的内存越少,8 张 V100 32GB 配 256 GB 就够。主线 llama.cpp 还跑不了,下面的速度按 ik_llama.cpp 估。
部分购买链接是联盟链接:通过它们购买时我们可能获得佣金,你支付的价格不变。
配方现在要求 vLLM 0.31.0 以上,pip 安装和官方 Docker 镜像都可以,首发时要用的 nightly 镜像和 deepseekv41-flash-0909 标签都不需要了。把 Engram 放进内存的参数是 --engram-config '{"cpu_offload":true}'。首次加载很慢,配方把就绪超时设成了 3600 秒。
mrfakename 已经按 1017 权重做了 2、3、4、8-bit 四档文件,体积已经核验。主线 llama.cpp 给 V4.1 开的 PR #28696 截至 10 月 18 日还没合并;ik_llama.cpp 9 月 22 日已经合并了 V4.1 支持,这几份文件里也带着它要读的 Engram 参数。文件里没有图片部分,只能处理文字;两张 Engram 表可以加 -ot "engram_embd.weight=CPU" 留在内存里。
不传参数时,思考默认开启、强度 50;max_tokens 给小了,输出长度会全花在思考上,正文是空的。强度可以填 1 到 100 的整数,但档位名在不同地方含义不同:vLLM 的 low、high、xhigh、max 对应 25、50、75、100,DeepSeek API 的 low、high、max 对应 50、75、100。vLLM 配方引用技术报告的说法,强度开到 60 到 80 就能拿回大部分精度,token 用量不到一半。
1017 的模型卡建议 temperature 和 top_p 都设 1.0,max_tokens 至少 256K。它的上下文非常省显存,1M 上下文的缓存不到 1 GB,开满也没什么代价。只处理文字时加 --language-model-only,跳过视觉部分,把显存留给上下文。
 vLLM
docker run --gpus all --privileged --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 -e VLLM_USE_RUST_FRONTEND=1 \
  vllm/vllm-openai:latest deepseek-ai/DeepSeek-V4.1-Flash-1017 \
  --tokenizer-mode deepseek_v41 --tensor-parallel-size 2 \
  --attention-config '{"backend":"FLASHINFER_MLA_SPARSE_DSV41","indexer_kv_dtype":"mxfp4","indexer_sparse_logits":true}' \
  --kv-cache-dtype fp8 --max-num-seqs 128 \
  --engram-config '{"cpu_offload":true}' \
  --tool-call-parser deepseek_v41 --enable-auto-tool-choice \
  --reasoning-parser deepseek_v41 --mm-encoder-tp-mode data
Ollama 只有云端版 deepseek-v4.1-flash:cloud,在 Ollama 的服务器上跑,不在你自己的机器上运行。
量化文件名以模型库当周抓取为准,口径见数据方法。 数据方法
| 模型 | 总参数 | 激活参数 | 4-bit 模型大小 |
|---|---|---|---|
| DeepSeek R1 Qwen3 8B稠密 | 8.2B | 8.2B | 5 GB |
| DeepSeek R1 Distill Qwen 14B稠密 | 14.8B | 14.8B | 9 GB |
| DeepSeek R1 Distill Qwen 32B稠密 | 32.8B | 32.8B | 19.9 GB |
| DeepSeek V4 FlashMoE | 284B | 13B | 155.1 GB |
| DeepSeek V3.2MoE | 671B | 37B | 405.4 GB |
| DeepSeek V4 ProMoE | 1,600B | 49B | 849.7 GB |