4 × Tesla V100 32GB + Xeon E5 デュアル DDR4
低予算生成速度37.4t/s
メモリ帯域幅137GB/s
マシン全体の参考価格—
 DeepSeek V4.1 Flash をローカルに導入するには?
DeepSeek V4.1 Flash は 2026 年 9 月に公開されたマルチモーダルの MoE で、重みファイルで数えると 763B のパラメータがあります。どの単体 GPU にも、128GB のマシンにも収まりません。10 月 17 日に出た 1017 版は重みを差し替えただけなので、動かすためのハードルは変わっていません。パラメータの大きな部分は参照テーブルとして使う「Engram メモリ」で、この部分はホストのメインメモリに置けるため、VRAM に載せなければならないのは約 300 GB だけです。公式のオリジナル重みは vLLM で動かします。コミュニティ製の GGUF はメインラインの llama.cpp ではまだ読み込めませんが、ik_llama.cpp なら対応済みで、エキスパートをメインメモリに置いて動かせます。Ollama にはクラウド版しかありません。
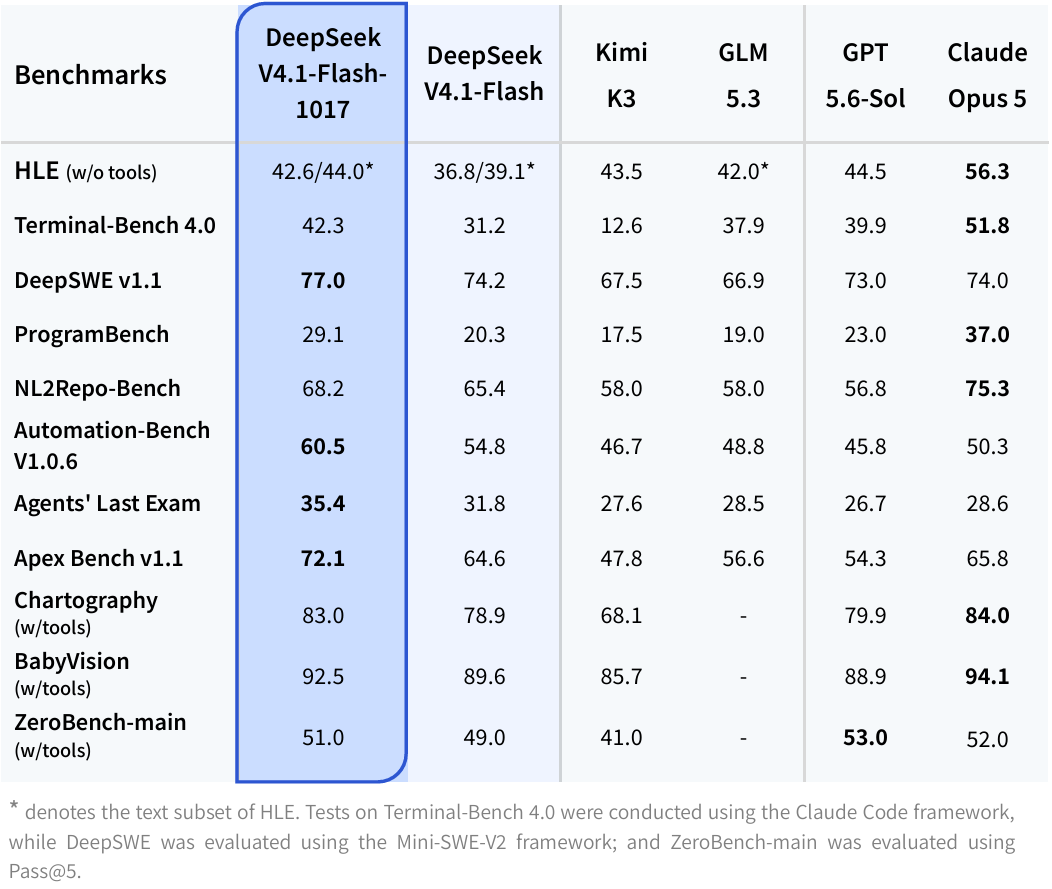
1017 は DeepSeek が 10 月 17 日に公開した重みの更新版で、推論、コーディング、エージェント、画像理解のベンチマークがそろって伸び、回答も短くなりました。モデル構造とファイルサイズは 9 月の初版とまったく同じです。DeepSeek の発表で伸びが最も大きいのはターミナル操作で作業をこなす Terminal-Bench 4.0 で、31.2 から 42.3 に上がり、同じタスクを少ないトークンでより速く終えられるようになっています。必要な VRAM も動くハードウェアも変わらないので、9 月版を動かしている人は起動コマンドのモデル名を DeepSeek-V4.1-Flash-1017 に変えるだけです。NVIDIA の NVFP4 版はまだ 1017 に追いついておらず、使うと 9 月版の重みになります。
モデルサイズは公式 Hugging Face リポジトリの Model size に合わせて 763B と表示しています。モデルカードにはバックボーン 552B と Engram 約 196B が別々に記載されています。以下の容量は GGUF 内の Engram テーブルを含む全分割ファイルの合計であり、パラメータ数からの推定ではありません。確認済みなのはファイルサイズで、量子化品質や実行時メモリ使用量ではありません。
| 量子化 | 重みサイズGB | 32K コンテキストGB | 128K コンテキストGB | 256K コンテキストGB | 1M コンテキスト(最大)GB |
|---|---|---|---|---|---|
| 1-bit | — | — | — | — | — |
| 2-bit | 264.5GGUF | 265.6 | 265.7 | 265.8 | 266.5 |
| 3-bit | 347.3GGUF | 348.4 | 348.5 | 348.6 | 349.3 |
| 4-bit | 444.7GGUF | 445.8 | 445.9 | 446 | 446.7 |
| 5-bit | — | — | — | — | — |
| 8-bit | 508GGUF | 509.1 | 509.1 | 509.3 | 510 |
| BF16/FP16 | — | — | — | — | — |
詳しい計算ルールはデータの作り方ページをご覧ください。
動かせません。しかも大きく足りません。単体 GPU の VRAM は最大 96GB ですが、2-bit でも約 266 GB 必要です。パラメータの大きな部分は参照用のテーブルで、1 トークンごとに数行を引くだけなのでメインメモリに逃がせますが、それでも VRAM に残すべき部分が約 300 GB あります。容量が足りるマシンは 512GB の Mac Studio M3 Ultra だけですが、コミュニティ製の量子化ファイルは本家の llama.cpp も Ollama もまだ読み込めません。Mac では DwarfStar の専用ブランチを試すしかなく、その重みもまだ 9 月版のままなので、確実とは言えません。きちんと動かす方法は 2 つあります。96GB のカード数枚と vLLM を使うか、ik_llama.cpp でエキスパートと Engram テーブルをメインメモリに置くかで、後者なら 4-bit でも 24GB のカード 1 枚と 512 GB メモリのサーバーで動きます。
| デバイス | 価格 | 速度 t/s | 最大コンテキスト |
|---|---|---|---|
| Mac Studio M3 Ultra 512GBマシン全体 · 512 GB | 価格なし | — | 1M |
| デバイス | 価格 | 速度 t/s | 最大コンテキスト |
|---|---|---|---|
| Mac Studio M3 Ultra 512GBマシン全体 · 512 GB | 価格なし | — | 1M |
| デバイス | 価格 | 速度 t/s | 最大コンテキスト |
|---|---|---|---|
| Mac Studio M3 Ultra 512GBマシン全体 · 512 GB | 価格なし | — | 1M |
よく使われる GPU とマシンだけを、価格の安い順に掲載しています。
組める最小構成は 96GB の RTX PRO 6000 4 枚です。条件は、vLLM で公式の重みを動かし、参照用テーブルをメインメモリに置くこと。GPU には VRAM に残す必要がある部分だけを載せ、ホストには約 203 GB の空きメモリを用意します。これで 4-bit が毎秒約 68 トークンです。48GB のカードを 8 枚そろえると合計容量は同じなのに収まりません。一部の重みを各カードに 1 つずつ複製して置く必要があり、カードが小さいほど不利になるためです。公式レシピが検証しているのは H100 や H200 8 枚といったデータセンター向けだけで、この 4 枚構成は容量と帯域からの推算なので、vLLM がこのカードに対応しているかを先に確認してください。
| デバイス | 必要枚数 | 合計価格 | 合計 VRAM | 速度 t/s | 合計消費電力 |
|---|---|---|---|---|---|
 RTX PRO 60001 枚 96 GB | 4 枚Engram は RAM | ¥14,752,000 | 384 GB | 68.1 | 2,400 W |
| A100 80GB PCIe1 枚 80 GB | 8 枚Engram は RAM | 価格なし | 640 GB | 71.7 | 2,400 W |
| Instinct MI2101 枚 64 GB | 8 枚Engram は RAM | 価格なし | 512 GB | 64 | 2,400 W |
| RTX PRO 5000 72GB1 枚 72 GB | 8 枚Engram は RAM | 価格なし | 576 GB | 55.5 | 2,400 W |
「Engram は RAM」の行は、別途約 203 GB のシステムメモリが必要です。詳しい計算ルールはデータの作り方ページをご覧ください。
96GB のカードを何枚も揃えられないが、大容量メモリのサーバーなら用意できる人向けの方法です。ik_llama.cpp でエキスパートと 2 つの Engram テーブルをメインメモリに置き、GPU には主にアテンションなどの常駐部分を載せます。カード 1 枚なら、4-bit で 512 GB 前後のメモリが必要です。カードを増やすほどエキスパートを VRAM に残せてメモリは少なくて済み、V100 32GB を 8 枚使えば 256 GB で足ります。メインラインの llama.cpp ではまだ動かないため、下の速度は ik_llama.cpp を前提にした推定です。
一部の購入リンクはアフィリエイトリンクです。リンク経由でご購入いただくと当サイトが手数料を受け取ることがありますが、お支払い金額は変わりません。
レシピの要件は vLLM 0.31.0 以上になり、pip でも公式の Docker イメージでも動きます。公開当初に必要だった nightly イメージや deepseekv41-flash-0909 タグはもう使いません。Engram をメインメモリに置くオプションは --engram-config '{"cpu_offload":true}' です。初回の読み込みは非常に遅く、レシピでは準備完了までのタイムアウトを 3600 秒に設定しています。
mrfakename が 1017 の重みから 2・3・4・8-bit の 4 種類を作っていて、サイズは確認済みです。メインラインの llama.cpp の V4.1 対応 PR(#28696)は 10 月 18 日時点でまだマージされていませんが、ik_llama.cpp は 9 月 22 日に V4.1 対応をマージ済みで、これらのファイルにはその読み込みに必要な Engram の設定も入っています。ファイルに画像部分はなく、テキスト専用です。2 つの Engram テーブルは -ot "engram_embd.weight=CPU" を付ければメインメモリに置いたまま使えます。
パラメータを渡さない場合、思考はオンで強度は 50 です。max_tokens を小さくしすぎると、出力枠をすべて思考に使い切って本文が空になります。強度には 1〜100 の整数を指定できますが、段階名の意味は場所によって異なります。vLLM の low、high、xhigh、max は 25、50、75、100 に、DeepSeek API の low、high、max は 50、75、100 に対応します。vLLM のレシピは技術レポートを引用し、強度を 60〜80 にすれば精度の大部分を取り戻せ、トークン消費は半分未満で済むとしています。
1017 のモデルカードの推奨は temperature、top_p ともに 1.0、max_tokens は 256K 以上です。コンテキストは VRAM を非常に節約する設計で、1M コンテキストでもキャッシュは 1 GB 未満なので、フルに使っても負担はほとんどありません。テキストだけを扱うなら --language-model-only を付けてビジョン部分を省き、その分の VRAM をコンテキストに回します。
 vLLM
実行前にデプロイガイドで必要な実行環境とハードウェアを確認してください。
docker run --gpus all --privileged --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 -e VLLM_USE_RUST_FRONTEND=1 \
  vllm/vllm-openai:latest deepseek-ai/DeepSeek-V4.1-Flash-1017 \
  --tokenizer-mode deepseek_v41 --tensor-parallel-size 2 \
  --attention-config '{"backend":"FLASHINFER_MLA_SPARSE_DSV41","indexer_kv_dtype":"mxfp4","indexer_sparse_logits":true}' \
  --kv-cache-dtype fp8 --max-num-seqs 128 \
  --engram-config '{"cpu_offload":true}' \
  --tool-call-parser deepseek_v41 --enable-auto-tool-choice \
  --reasoning-parser deepseek_v41 --mm-encoder-tp-mode data
Ollama にはクラウド版の deepseek-v4.1-flash:cloud しかなく、手元のマシンではなく Ollama のサーバーで動きます。
ファイル名はその週のモデルライブラリ取得時点のものです。定義はデータ方法を参照してください。 データ方法
| モデル | 総パラメータ | アクティブ | 4-bit のサイズ |
|---|---|---|---|
| DeepSeek R1 Qwen3 8BDense | 8.2B | 8.2B | 5 GB |
| DeepSeek R1 Distill Qwen 14BDense | 14.8B | 14.8B | 9 GB |
| DeepSeek R1 Distill Qwen 32BDense | 32.8B | 32.8B | 19.9 GB |
| DeepSeek V4 FlashMoE | 284B | 13B | 155.1 GB |
| DeepSeek V3.2MoE | 671B | 37B | 405.4 GB |
| DeepSeek V4 ProMoE | 1,600B | 49B | 849.7 GB |