Tesla V100 32GB + E5 雙路 DDR4
低價生成速度22t/s
記憶體頻寬137GB/s
整機參考價NT$64,734
 DeepSeek V4.1 Flash 如何本地部署?
DeepSeek V4.1 Flash 是 2026 年 9 月發布的多模態 MoE,以權重檔計算有 763B 參數,任何單卡和 128GB 整機都放不下。10 月 17 日推出的 1017 版只換了權重,部署門檻不變。它的參數中有一大塊是查表用的「Engram 記憶」,這部分可以放進主機記憶體,只有約 300 GB 非放進顯示記憶體不可。官方原版權重要用 vLLM 執行;社群 GGUF 主線 llama.cpp 還無法載入,但 ik_llama.cpp 已經支援,可以把專家放進主機記憶體執行;Ollama 只有雲端版。
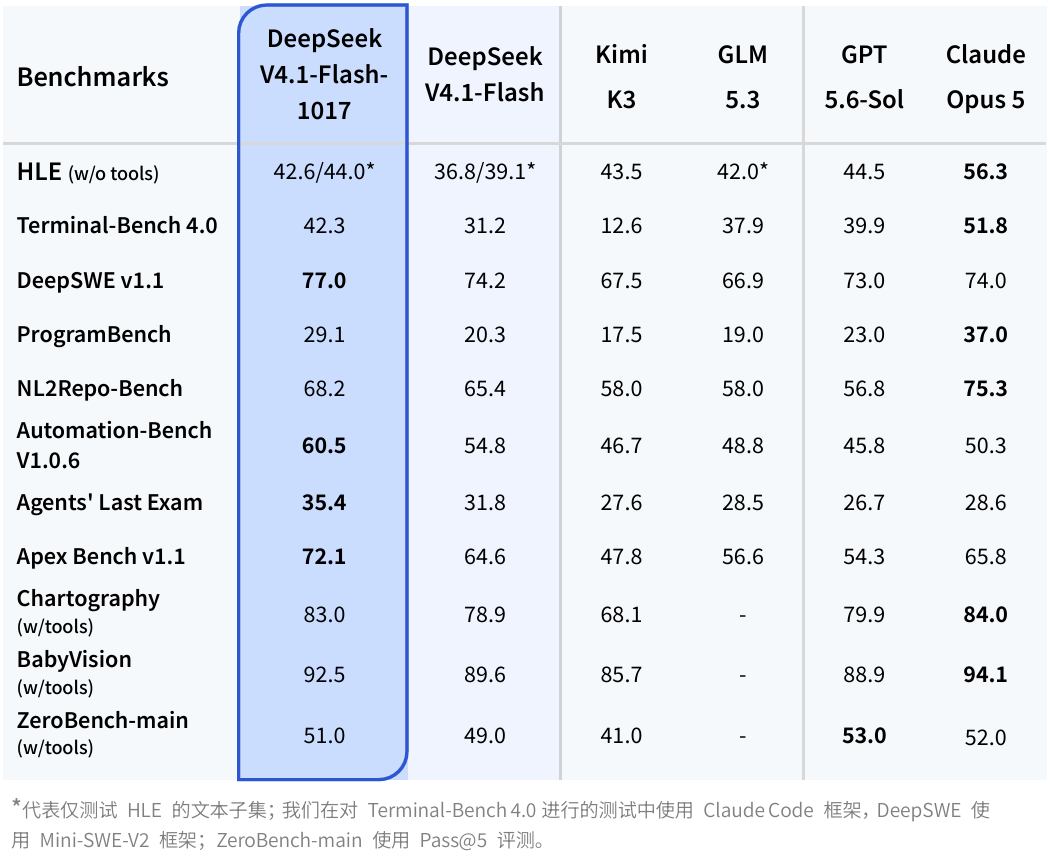
1017 是 DeepSeek 在 10 月 17 日推出的新版權重:推理、寫程式、agent 任務和看圖的跑分都有進步,回答也變短了,模型架構和檔案體積則和 9 月首發版一模一樣。官方跑分中進步最多的是在終端機裡完成任務的 Terminal-Bench 4.0,從 31.2 提高到 42.3;同樣的任務花的 token 更少,完成得也更快。顯示記憶體需求和能跑的硬體都沒變,已經在跑 9 月版的人,把啟動指令裡的模型名稱換成 DeepSeek-V4.1-Flash-1017 就好;NVIDIA 的 NVFP4 版還沒跟上,用它跑的仍是 9 月權重。
模型大小依官方 Hugging Face 倉庫的 Model size 顯示為 763B;模型卡中的 552B 指骨幹參數,另列約 196B Engram。下列檔案大小包含 GGUF 內的 Engram 查表,按實際分片加總,不由參數量乘以量化位元寬度推算。僅核驗檔案大小,未驗證量化品質或實際執行用量。
| 量化 | 權重體積GB | 32K 上下文GB | 128K 上下文GB | 256K 上下文GB | 1M 上下文(最大)GB |
|---|---|---|---|---|---|
| 1-bit | — | — | — | — | — |
| 2-bit | 264.5GGUF | 265.6 | 265.7 | 265.8 | 266.5 |
| 3-bit | 347.3GGUF | 348.4 | 348.5 | 348.6 | 349.3 |
| 4-bit | 444.7GGUF | 445.8 | 445.9 | 446 | 446.7 |
| 5-bit | — | — | — | — | — |
| 8-bit | 508GGUF | 509.1 | 509.1 | 509.3 | 510 |
| BF16/FP16 | — | — | — | — | — |
詳細計算規則可在資料方法頁查看。
不能,而且差得很遠:單張顯示卡最多 96GB,它壓到 2-bit 也要約 266 GB。它有一大塊參數是查表用的記憶資料,每產生一個字只查其中幾行,可以移到主機記憶體;但移走之後,必須留在顯示記憶體裡的部分仍有約 300 GB。整機裡容量夠的只有 512GB 的 Mac Studio M3 Ultra,可是社群做的量化檔案,主線 llama.cpp 和 Ollama 目前都還載入不了,Mac 上只能試 DwarfStar 的專用分支,它搭配的權重也還是 9 月版,稱不上穩當。想認真跑有兩條路:幾張 96GB 的卡加上 vLLM,或是用 ik_llama.cpp 把專家和 Engram 表放進主機記憶體,4-bit 下一張 24GB 的卡加上 512 GB 記憶體的伺服器就能跑。
| 裝置 | 價格 | 速度 t/s | 最大上下文 |
|---|---|---|---|
| Mac Studio M3 Ultra 512GB整機 · 512 GB | NT$610,6793 筆掛單 | — | 1M |
| 裝置 | 價格 | 速度 t/s | 最大上下文 |
|---|---|---|---|
| Mac Studio M3 Ultra 512GB整機 · 512 GB | NT$610,6793 筆掛單 | — | 1M |
| 裝置 | 價格 | 速度 t/s | 最大上下文 |
|---|---|---|---|
| Mac Studio M3 Ultra 512GB整機 · 512 GB | NT$610,6793 筆掛單 | — | 1M |
只列常見的顯示卡和整機,按價格從低到高排。
最小的組合是 4 張 96GB 的 RTX PRO 6000,前提是用 vLLM 跑官方權重,並把查表用的那塊記憶資料放進主機記憶體:顯示卡只放必須進顯示記憶體的部分,主機則要空出約 203 GB 記憶體。這樣跑 4-bit,每秒約 68 個 token。48GB 的卡湊滿 8 張,總容量一樣卻放不下,因為有一部分權重要在每張卡上各放一份,卡越小越吃虧。官方配方只驗證過 8 張 H100、H200 這類資料中心硬體,四卡方案是依容量和頻寬推算的,動手前先確認 vLLM 對這張卡的支援。
| 裝置 | 需要幾張 | 總價 | 總顯示記憶體 | 速度 t/s | 總功耗 |
|---|---|---|---|---|---|
| Instinct MI210單卡 64 GB | 8 張Engram 放記憶體 | NT$722,427 | 512 GB | 64 | 2,400 W |
 RTX PRO 5000 72GB單卡 72 GB | 8 張Engram 放記憶體 | NT$2,319,273 | 576 GB | 55.5 | 2,400 W |
| RTX PRO 6000單卡 96 GB | 4 張Engram 放記憶體 | NT$2,538,375 | 384 GB | 68.1 | 2,400 W |
| A100 80GB PCIe單卡 80 GB | 8 張Engram 放記憶體 | NT$5,467,312 | 640 GB | 71.7 | 2,400 W |
標「Engram 放記憶體」的另需約 203 GB 系統記憶體。詳細計算規則可在資料方法頁查看。
適合手上有大記憶體伺服器、又湊不齊幾張 96GB 卡的人:用 ik_llama.cpp 把專家和兩張 Engram 表都放進主機記憶體,顯示卡主要放注意力這類常駐部分,只配一張卡時,4-bit 需要 512 GB 左右的記憶體。卡越多,能留在卡上的專家越多、需要的記憶體越少,8 張 V100 32GB 配 256 GB 就夠。主線 llama.cpp 還跑不了,下面的速度以 ik_llama.cpp 估算。
部分購買連結是聯盟連結:透過它們購買時我們可能獲得佣金,你支付的價格不變。
配方現在要求 vLLM 0.31.0 以上,用 pip 安裝或官方 Docker 映像檔都可以,首發時需要的 nightly 映像檔和 deepseekv41-flash-0909 標籤都用不到了。把 Engram 放進記憶體的參數是 --engram-config '{"cpu_offload":true}'。第一次載入很慢,配方把就緒逾時設成了 3600 秒。
mrfakename 已經用 1017 權重做出 2、3、4、8-bit 四檔檔案,體積核對過了。主線 llama.cpp 為 V4.1 開的 PR #28696 截至 10 月 18 日仍未合併;ik_llama.cpp 在 9 月 22 日已經合併 V4.1 支援,這幾份檔案也帶著它要讀的 Engram 參數。檔案裡沒有圖片部分,只能處理文字;兩張 Engram 表可以加上 -ot "engram_embd.weight=CPU" 留在主機記憶體裡。
不帶參數時,思考預設開啟、強度 50;max_tokens 設得太小,輸出長度會全部耗在思考上,正文變成空白。強度可以填 1 到 100 的整數,但檔位名稱在不同地方代表的數值不一樣:vLLM 的 low、high、xhigh、max 對應 25、50、75、100,DeepSeek API 的 low、high、max 則對應 50、75、100。vLLM 配方引用技術報告的說法:強度開到 60 到 80 就能拿回大部分精度,token 用量還不到一半。
1017 的模型卡建議 temperature 和 top_p 都設為 1.0,max_tokens 至少 256K。它的上下文非常省顯示記憶體,1M 上下文的快取不到 1 GB,開滿也幾乎沒有代價。只處理文字時加上 --language-model-only,略過視覺部分,把顯示記憶體留給上下文。
 vLLM
docker run --gpus all --privileged --ipc=host -p 8000:8000 \
  -v ~/.cache/huggingface:/root/.cache/huggingface \
  -e VLLM_ENGINE_READY_TIMEOUT_S=3600 -e VLLM_USE_RUST_FRONTEND=1 \
  vllm/vllm-openai:latest deepseek-ai/DeepSeek-V4.1-Flash-1017 \
  --tokenizer-mode deepseek_v41 --tensor-parallel-size 2 \
  --attention-config '{"backend":"FLASHINFER_MLA_SPARSE_DSV41","indexer_kv_dtype":"mxfp4","indexer_sparse_logits":true}' \
  --kv-cache-dtype fp8 --max-num-seqs 128 \
  --engram-config '{"cpu_offload":true}' \
  --tool-call-parser deepseek_v41 --enable-auto-tool-choice \
  --reasoning-parser deepseek_v41 --mm-encoder-tp-mode data
Ollama 只有雲端版 deepseek-v4.1-flash:cloud,在 Ollama 的伺服器上執行,不在你自己的電腦上跑。
量化檔名以模型庫當週抓取為準,口徑見資料方法。 資料方法
| 模型 | 總參數 | 激活參數 | 4-bit 模型大小 |
|---|---|---|---|
| DeepSeek R1 Qwen3 8B稠密 | 8.2B | 8.2B | 5 GB |
| DeepSeek R1 Distill Qwen 14B稠密 | 14.8B | 14.8B | 9 GB |
| DeepSeek R1 Distill Qwen 32B稠密 | 32.8B | 32.8B | 19.9 GB |
| DeepSeek V4 FlashMoE | 284B | 13B | 155.1 GB |
| DeepSeek V3.2MoE | 671B | 37B | 405.4 GB |
| DeepSeek V4 ProMoE | 1,600B | 49B | 849.7 GB |